현재 개발중인 프로젝트에서는 로그인한 사용자에게 발급된 refreshToken을 저장하는 용도로 redis를 사용하고 있다.
사용자가 로그인해 토큰을 발급받으면, redis에 다음과 같은 형태로 저장한다.
key: refresh:{loginId}:{jti}
value: {refreshToken}
만약 사용자가 비밀번호를 변경한다면, 보안상의 이유로 해당 사용자가 로그인한 전체 기기에서 로그아웃시켜야 한다.
이를 해당 사용자의 모든 refreshToken을 삭제하고, jti를 blacklist에 등록하여 무효화하는 방식으로 구현하고자 했다.
KEYS 명령
처음에는 keys 명령으로 refresh:{loginId}:* 패턴에 부합하는 키를 조회해 처리하려 했다.
하지만 이 방법에는 성능 문제점이 있다는 것을 발견했다.
KEYS 명령은 시간 복잡도가 O(N)인 명령으로, 패턴에 일치하는 모든 키를 반환하기 위해 전체 키 공간을 스캔한다.
또, redis는 싱글 스레드 구조이기 때문에 해당 명령이 실행되는 도중에는 다른 모든 명령의 실행이 블로킹된다.
따라서 대규모 데이터 세트에서 사용하면 성능 저하를 유발할 수 있어 사용에 주의가 필요하다.
Redis 공식 문서에 따르면 보급형 노트북에서 실행되는 Redis는 100만개의 키를 40밀리초 안에 검색할 수 있다고 한다.
하지만 성능 저하의 문제로 프로덕션 환경에서 이 명령을 사용하지 않을 것을 권장하고 있다.
앞서 말했듯이, 대량의 키가 존재하는 환경에서 KEYS 명령 실행 시 전체 시스템의 응답 지연이 발생해 최악의 경우 서비스 전체가 일시적으로 중단될 수 있기 때문이다.
SCAN 명령
대안으로 SCAN이라는 명령을 사용할 수 있다.
SCAN 명령은 시간복잡도가 O(1)이고, 커서가 다시 0으로 돌아올 때까지의 명령어 호출을 포함하는 완전한 반복에 대해서는 O(N)이다. N은 컬렉션 안의 요소 수를 의미한다.
한 번에 일부 결과만 반환하는 커서 기반의 점진적 반복 방식을 사용하기 때문에, 대량의 키나 요소에 대해 호출하더라도 서버를 오랫동안 블로킹하는 KEYS와 달리 운영 환경에서도 안전하게 사용할 수 있다.
공식 문서에서 제공하는 예제를 보며 더 알아보자.
> scan 0
1) "17"
2)  1) "key:12"
    2) "key:8"
    3) "key:4"
    4) "key:14"
    5) "key:16"
    6) "key:17"
    7) "key:15"
    8) "key:10"
    9) "key:3"
   10) "key:7"
   11) "key:1"
> scan 17
1) "0"
2) 1) "key:5"
   2) "key:18"
   3) "key:0"
   4) "key:2"
   5) "key:19"
   6) "key:13"
   7) "key:6"
   8) "key:9"
   9) "key:11"
SCAN은 커서 기반의 반복자다. 각 호출마다 다음 호출에 사용할 커서 인자를 반환해 준다.
위 예시를 보면 첫 번째 호출에서 커서를 0으로 설정해 호출했고, 다음 호출에는 이전 호출에 반환된 첫 번째 요소 값을 커서로 설정해 호출했다.
첫 번째 호출에서 반환된 17이라는 값은 다음 순회의 시작점이 될 업데이트된 커서를 의미한다.
두 번째 호출에서는 반환된 커서 값이 0인데, 이는 컬렉션 순회가 완전히 끝났다는 것을 알려주는 신호이며, 이를 전체 순회라고 한다.
SCAN 명령어와 그 계열은 전체 순회에 대해 다음을 보장한다.
- 전체 순회 동안 컬렉션에 존재했던 모든 요소는 반드시 한 번은 반환됨(시작될 때 존재했고, 끝날 때까지 삭제되지 않은 요소는 어떤 시점에서든 반드시 반환됨)
- 전체 순회 동안 한 번도 존재하지 않았던 요소는 반환되지 않음(시작되기 전에 삭제되었고, 끝날 때까지 추가되지 않은 요소는 반환되지 않음)
하지만 SCAN은 내부적으로 거의 상태 정보를 저장하지 않고, 단지 커서 정보만 유지한다. 이로 인해 다음과 같은 단점이 있다.
- 동일한 요소가 여러 번 반환될 수 있음(애플리케이션 단에서 중복 요소 처리해야 함. 예를 들어 같은 작업을 여러 번 수행해도 안전한 방식으로)
- 전체 순회 중간에 추가되거나 삭제된 요소는 반환될 수도 있고, 안 될 수도 있음(이런 요소의 반환 여부는 보장되지 않음)
SCAN 계열 명령은 매번 호출될 때 반환되는 요소의 수에 대한 명확한 범위를 보장하지 않는다.
심지어 0개 요소를 반환할 수도 있고, 커서 값이 0이 되기 전까지는 반복이 끝났다고 간주해서는 안 된다.
COUNT 옵션으로 매 순회마다 반환할 요소 개수를 지정할 수 있는데, 기본값은 10이다. 이 COUNT 값은 구현체에 대한 '힌트'일 뿐이고, 반드시 그 개수의 값이 반환됨을 보장하지는 않는다.
이 수치가 커질수록 전체 순회에 소요되는 시간은 짧아지지만, 대상이 되는 테이블 범위도 커져 블로킹 시간이 증가하게 될 수 있다. (KEYS 사용 시와 비슷한 문제)
JMETER를 활용한 실제 성능 비교
KEYS 명령을 사용하는 것이 위험하다는 것을 실제로 확인해보기 위해 JMETER를 사용한 테스트를 진행해보고자 했다.
서버에 계속 요청이 들어오는 상태에서, keys 명령을 실행할 때와 scan 명령을 실행할 때 기본 요청들의 응답 지연 시간이 어떻게 변화하는지를 확인하는 테스트를 실행했다.
먼저 테스트할 데이터를 준비한다.
- 키 형식: test:userXxx:uuid
- 사용자 수: 100,000명
- 사용자당 토큰 수: 5개
- 총 키 개수: 500,000개
데이터 생성 코드
import redis
import uuid

r = redis.Redis(host='localhost', port=6379, db=0)
pipe = r.pipeline()

num_users = 100_000
tokens_per_user = 5

for user_id in range(num_users):
    for token_idx in range(tokens_per_user):
        key = f"test:user{user_id}:{uuid.uuid4()}"
        pipe.set(key, f"value_{user_id}_{token_idx}")

        if (user_id * tokens_per_user + token_idx) % 1000 == 0:
            pipe.execute()

pipe.execute()

# dummy:load:key 추가
r.set("dummy:load:key", "dummy_value")
다음으로는 다음 세 가지 API를 구현한다.
- /test/heartbeat -> Redis 조회 부하 시뮬레이션용 트래픽 발생용. 단순 조회로 구현한다.
- /test/keys/{loginId} -> Redis keys 명령 실행용
- /test/keys/{loginId} -> Redis scan 명령 실행용
테스트용이므로 매우 단순하게 구현했다.
TestController.java
@RequestMapping("/test")
@RestController
@RequiredArgsConstructor
@Validated
public class TestController {

    private final TestService testService;

    @GetMapping("/heartbeat")
    public ResponseEntity<Void> heartbeat() {
        testService.heartbeat();
        return ResponseEntity.ok().build();
    }

    @GetMapping("/keys/{loginId}")
    public ResponseEntity<Set<String>> testKeys(@NotBlank @PathVariable String loginId) {
        return ResponseEntity.ok(testService.testKeys(loginId));
    }

    @GetMapping("/scan/{loginId}")
    public ResponseEntity<Set<String>> testScans(@NotBlank @PathVariable String loginId) {
        return ResponseEntity.ok(testService.testScan(loginId));
    }
}
TestService.java
@Service
@RequiredArgsConstructor
public class TestService {

    private final StringRedisTemplate stringRedisTemplate;

    public void heartbeat() {
        stringRedisTemplate.opsForValue().get("dummy:load:key");
    }

    public Set<String> testKeys(String loginId) {
        return stringRedisTemplate.keys("test:" + loginId + ":*");
    }

    public Set<String> testScan(String loginId) {
        return stringRedisTemplate.execute((RedisConnection connection) -> {
            ScanOptions options = ScanOptions.scanOptions()
                .match("test:" + loginId + ":*")
                .count(100)
                .build();

            Set<String> result = new HashSet<>();

            try (Cursor<byte[]> cursor = connection.keyCommands().scan(options)) {
                cursor.forEachRemaining(keyBytes ->
                    result.add(new String(keyBytes, StandardCharsets.UTF_8))
                );
            }
            return result;
        });
    }
}
테스트 설정
/test/keys/{loginId}나 /test/scan/{loginId}은 어차피 한 번만 실행해보면 되기 때문에, 계속해서 부하를 주는 상태에서 postman으로 직접 요청을 보내보기로 했다.
따라서 JMETER 스레드 그룹은 다음과 같은 설정으로 하나만 구성했다.
100개의 스레드가 10초에 걸쳐 순차적으로 시작되고, 이후 각 스레드는 무한 반복으로 요청을 보내도록 구성했다.
각 요청 사이에는 평균 200ms, 표준편차 50ms의 정규분포를 따르는 지연(Gaussian delay)이 적용했다.
각 스레드가 요청 간 간격을 독립적으로 가지고, 루프를 돌 때마다 새로운 지연 시간을 적용받는다.
(사용자의 불규칙한 요청 간격(클릭/입력)을 시뮬레이션 하기 위함)
Thread Group
- Number of Threads : 100
- Ramp-up period : 10
- Loop Count : Infinite
Http Request
- http://localhost:8080
- GET /test/heartbeat
Gaussian Random Timer
- Deviation : 50.0
- Constant Delay Offset : 200
Listener로는 View Results Tree, Summary Report, jp@gc - Response Times Over Time을 추가해 관찰했다.
테스트 결과
1. 기본 성능
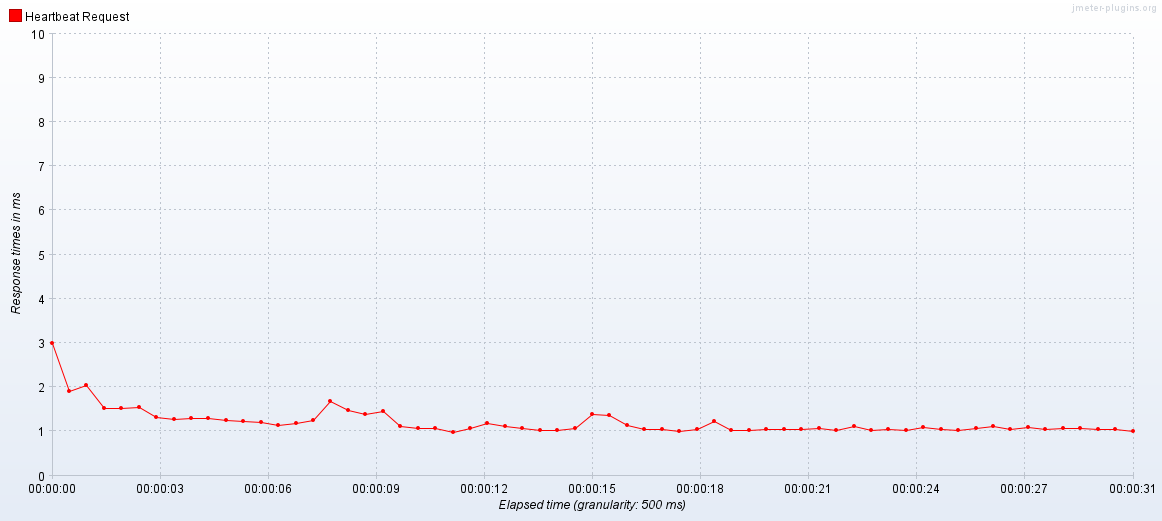
기본 redis get 요청만 30초가량 진행했을 때의 표다.
| Label | # Samples | Average | Min | Max | Throughput |
| Heartbeat Request | 12821 | 1 | 0 | 11 | 418.2/sec |
평균 1ms의 응답 시간을 갖는 것을 확인할 수 있다.
2. KEYS 명령 실행 시
초기화 후 다시 실행하면서, postman으로 GET /test/keys/userXxx로 요청을 보냈다.
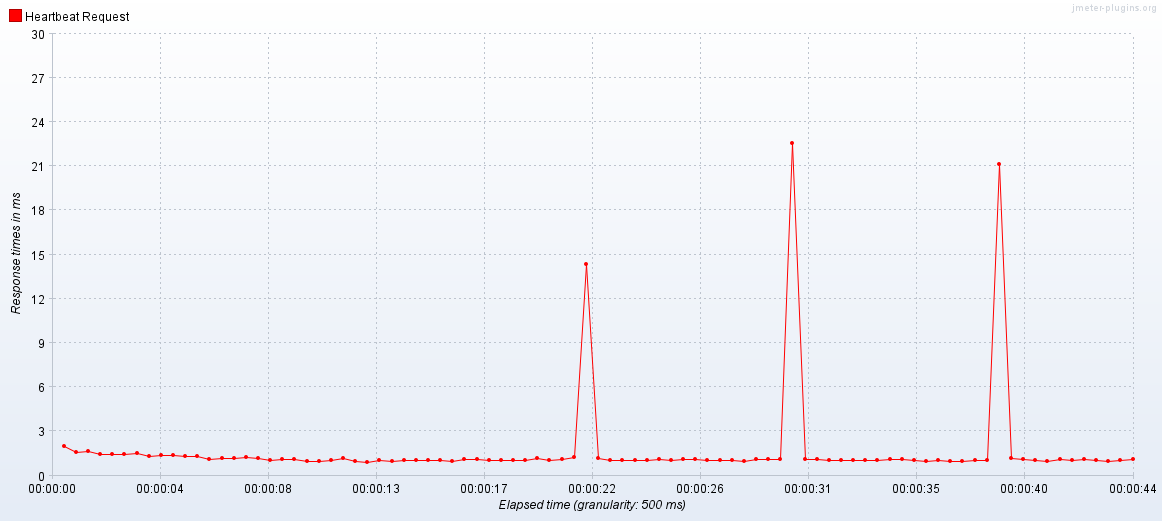
21초, 30초, 38초 쯤에 응답 시간이 급격히 증가한 걸 확인할 수 있다.

Max 응답 시간도 138ms다.
실제로 postman에 찍힌 응답 시간이 140ms 가량 되니, keys 명령을 처리하는 동안 블로킹되었음을 확인할 수 있다.
3. SCAN 명령 실행 시
다시 초기화하고, 기본 부하 실행 중 scan 명령을 실행했을 때의 표를 확인해 보자.
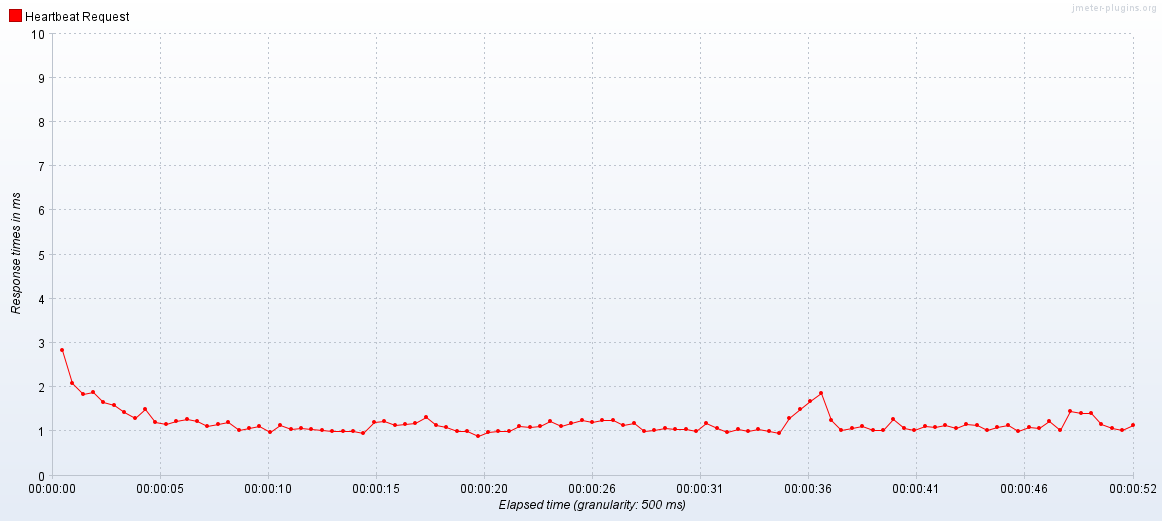
크게 튀는 값 없이 안정적으로 응답 시간이 나오는 걸 확인할 수 있다.

Max 응답 시간도 10ms로, 기본 테스트 실행 시와 큰 차이가 없다.
SCAN의 문제점
앞서 실행한 테스트를 통해 KEYS 명령 실행 시 전체 시스템 응답 시간이 keys 명령이 처리되는 동안 블로킹되어 증가했음을 확인할 수 있었다. 반면 SCAN 명령은 동일한 작업을 수행하면서도, 시스템 성능에 거의 영향을 주지 않았다.
하지만 SCAN 명령에도 한계가 있다.
다음 이미지를 보자.
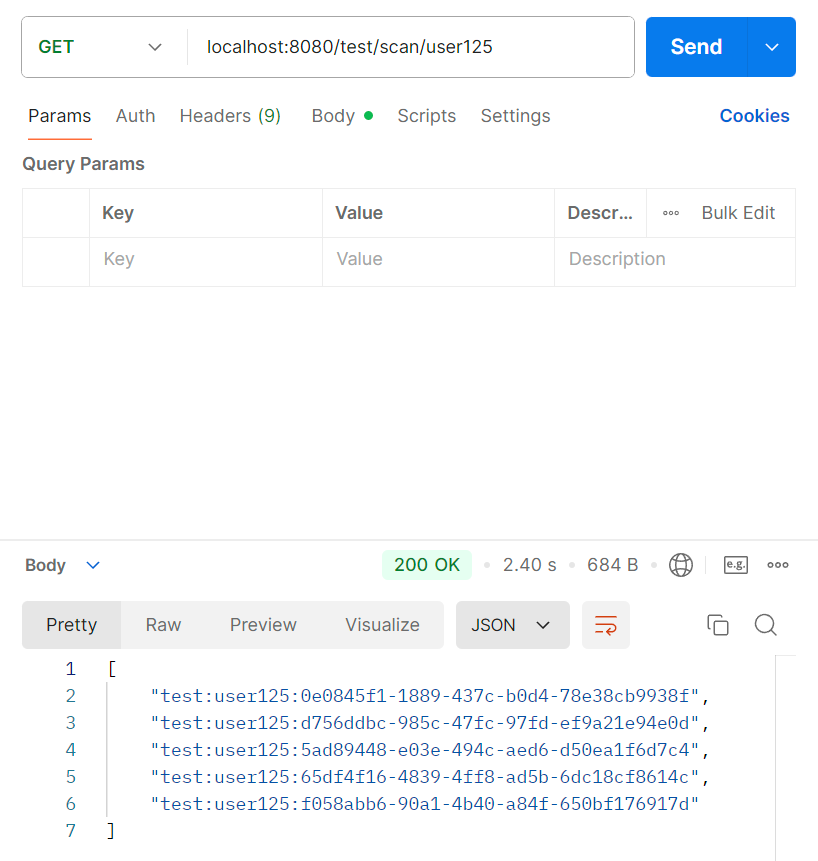
응답 시간이 2.40s로, 매우 느린 실행 시간을 가지는 것을 확인할 수 있다.
이는 COUNT 값만큼 분할해서 확인하기 때문인데, COUNT 값을 조정한다 해도 redis 자체에 저장된 데이터 개수에 따라 속도가 가변적이기 때문에 성능이 불확실하다.
만약 내가 구현하는 대상이 '다른 요청을 방해하지 않되, 자기 자신은 느릴 수 있는 명령'이었다면 문제가 되지 않았겠지만,
실제 구현하고자 하는 것은 최대한 빠른 응답일수록 유리하다.
따라서 이 문제를 SCAN으로 해결하는 대신, 다른 해결책을 찾기로 했다.
정리
KEYS는 빠르지만 블로킹되는 명령이기 때문에 프로덕션 환경에서는 사용하기에 위험하다는 사실을 테스트를 통해 확인했다. 대신 SCAN 명령은 서버를 차단하지 않고 안전하게 키를 순회할 수 있어 운영 환경에서는 더 적절한 선택이 될 수 있다.
비록 나의 경우는 즉시 결과가 반환되는 것이 중요한 기능을 구현해야 했기에 SCAN을 사용하는 것이 부적절했지만, 백그라운드에서 점진적으로 처리해도 되는 작업(예를 들어 통계 작업이나 캐시를 정리하는 스케줄링 작업 등...)이라면 SCAN이 매우 유용할 수 있다.
다음 게시글에서는 SCAN 대신 어떤 방식으로 문제를 해결했는지에 대해 다루어 보겠다.
참고
https://velog.io/@sejinkim/Redis-KEYS-vs-SCAN
https://redis.io/docs/latest/commands/keys/
https://redis.io/docs/latest/commands/scan/